本周,OpenAI发布了数百份其声称可解答世界上一些最难数学问题的方案。这家前沿实验室表示,它已咨询了一个由顶尖数学家组成的咨询小组,以避免上一次其某个模型解决该领域一个长期悬而未决问题时引发的争议。
但OpenAI未能达到这些标准,尤其是在数学家们强调需要对数学结果形成人类理解的地方。这一点尤其令人担忧,因为一篇新论文凸显了OpenAI模型表面上解决的一个百万美元难题,其自然语言解答与形式化表达的解答之间存在落差。
数学与人工智能咨询组(AGMAI)由普林斯顿高等研究院主办,由来自全球各地机构的九位知名研究人员组成。
该组织在9月底发布了面向解决数学问题的前沿实验室的指导方针。在就最新一批证明发表的声明中,AGMAI表示:“我们的建议在多大程度上得到成功遵循,最终应由数学界来评估。”
然而,该组织的首要要求是“停止在专有模型上测试高等数学问题”。OpenAI的发布内容明确表示,它正在使用数学领域的开放研究问题来评估其专有模型。
当TechCrunch要求对OpenAI最新的证明发布进行更全面评估时,该咨询组并未回应。实验室显然遵循了其中一些原则,包括尽快发布结果,并包含模型如何得出结论的信息。但并非所有结果都如此:719份手稿中只有10份公开了模型的思维链。
对于人们无法理解的论文,这些数学家建议应将证明形式化——但OpenAI发布的证明中,仅有42%尚未经过这一过程。
最终,仍不清楚OpenAI在发布其证明时,是否按照AGMAI的原则承担了“确保人类理解能够随之而来”的责任。AGMAI建议,OpenAI应帮助资助人类数学家的工作,因为要让该实验室的解答真正具有意义,这些数学家将是必需的。
“问题正由AI提示者自主解决,而这些人一旦最初目标被‘解决’,便对更广泛领域本身毫无兴趣,也不够理解AI输出,无法就结果回答问题、作报告,或以其他方式与该领域其他人互动。”曾批评OpenAI做法的著名数学家陶哲轩在发布后于社交媒体上写道。
这个问题的一个例证,是剑桥大学和伦敦国王学院的数学家本周发布的一篇论文,该论文质疑前沿实验室应对这些挑战的方式。
当AI模型解决数学问题时,它们首先会生成“自然语言”解释,然后尝试用Lean表达该结果。Lean是一种编程语言,理论上可通过将其编译为代码来确认证明的准确性。
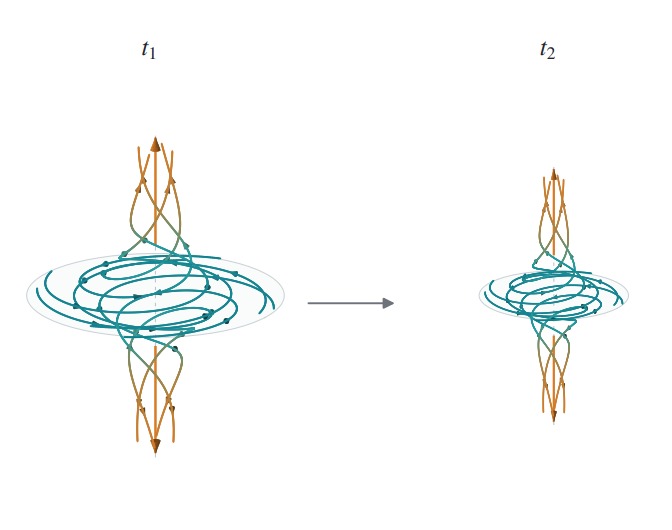
然而,模型将自然语言证明转化为代码的方式可能存在问题;这篇论文记录了至少两处不一致:OpenAI针对一个由纳维-斯托克斯方程衍生的问题所提供的解答,其自然语言证明与背后的Lean代码之间存在差异。纳维-斯托克斯方程描述流体的复杂行为。
这些不一致不一定能否定任一解答,但它们确实提出了一个问题:我们能否在没有人参与的情况下,单纯依赖模型将其自身的解答形式化。这也是AGMAI要求OpenAI“包含将自然语言与形式化产物关联起来的机器可读元数据”的原因之一,而这家前沿实验室在这些发布中并未做到。
“由于误译现象——正如本论文所强调——OpenAI的自然语言证明以及其他自动形式化的Lean证明,不应在未经与其他证明同样的同行评审过程和严格审查之前,就被初步信任。”这篇题为“在翻译中迷失”的论文作者总结道。
数学家们强调,当人类发现新结果时,他们会对其负责,并通过论文、报告和研讨会与更广泛的学界互动。这一过程增进了对解答的理解,发现可用于解决其他问题的策略,并使新知识能够应用于实际领域。
当模型被提示解决一个难题并给出解答时,“在发布时并不存在人类对它们的理解,而现在工作才刚开始,”哈佛大学数学教授梅兰妮·伍德对TechCrunch表示。
